📊 Statystyka w zarządzaniu (dr Katarzyna Piotrowska)
Wejściówki (mini-sprawdziany), ściągi z wykładów i tablicy, trener RStudio oraz kreator Projektu cz. I na piątek 6.11.
🎯 Symulator Wejściówek (Mini-sprawdziany na początek zajęć)
Wybierz tryb sprawdzianu. Po każdej odpowiedzi od razu zobaczysz wyjaśnienie krok po kroku, a każde pytanie z pomyłką automatycznie trafi do zakładki „Powtórka moich błędów”.
✍️ Trener Rachunkowy i Pisania Komend w R (wpisywanie odpowiedzi)
Ćwicz liczenie (dokładnie jak na tablicy z zajęć) oraz pisanie komend w RStudio z pamięci.
📝 Zadanie 1: „Projekt grupowy – cz. I – temat i zmienne” (termin: piątek 6.11, godz. 21:00)
Poniżej masz opracowane 3 kompletne propozycje tematów badania (w pełni zgodne z wytycznymi dr Katarzyny Piotrowskiej z Blackboarda), gotowe pliki Word (.docx) do pobrania oraz interaktywny konfigurator, w którym możesz dostosować wybrany temat i pobrać własny plik Word.
- Populacja z Waszego otoczenia: badacie osoby ze swojego otoczenia (np. pracujących studentów ALK i współpracowników), a nie „młodych ludzi w Polsce” (zgodnie z ostrzeżeniem z instrukcji).
- Konceptualizacja = definicja + wskaźniki: w punkcie 1 jest precyzyjna definicja głównego zjawiska oraz wypunktowane wskaźniki (po czym poznajemy jego poziom) i pytania badawcze („czego chcemy się dowiedzieć”).
- Min. 2 zmienne na skalach słabszych (nominalna + porządkowa) mające ≥3 warianty: w materiałach prowadzącej zmienna z 2 odpowiedziami (tak/nie) to zmienna dychotomiczna, a nie skala nominalna/porządkowa — dlatego każda nasza zmienna słabsza ma 5–7 kategorii rozłącznych i wyczerpujących.
- Min. 2 zmienne na skalach mocniejszych (interwałowa 0–10 + ilorazowa): zmienne ilorazowe pytają o dokładną liczbę (minut, dni, zł), a nie o przedziały (bo przedziały zdegradowałyby skalę ilorazową do porządkowej!).
- Łatwe do policzenia w R w dalszej części semestru: respondenci odpowiedzą na te pytania w 2 minuty, a Wy bez trudu policzycie z nich w R średnie, mediany, tabele częstości, wykresy słupkowe i histogramy.
Wybierz jeden z 3 gotowych wariantów (kliknij, aby załadować do edytora poniżej lub od razu pobierz plik .docx):
⭐ Wariant A (Rekomendowany): Praca zdalna/hybrydowa a Work-Life Balance
Najbardziej uniwersalny temat z zarządzania. Wykorzystuje czas dojazdu w minutach (dokładnie z PDF-a prowadzącej o konceptualizacji!).
🤖 Wariant B: Narzędzia generatywnej AI w pracy i na studiach
Świetny, aktualny temat bliski Twoim zainteresowaniom. Mierzy czas pracy z AI w minutach, wydatki w zł, weryfikację błędów i ocenę 0–10.
📱 Wariant C: Wieczorna higiena cyfrowa (smartfon przed snem) a sen
Bezpośrednie rozwinięcie przykładu dr Piotrowskiej ze skryptu 3.10.R (czas_bez_tel_sen i jakie_urzadzenie_najcz).
🛠️ Edytor i Konfigurator Waszego Projektu cz. I (możesz dowolnie zmienić tekst i pobrać gotowy plik do Worda)
ASkale pomiarowe — jak rozpoznać w 5 sekund i co wolno liczyć
= ≠ · brak jednostki< > · rangi, przedziały+ − · zero względne (umowne)× ÷ · zero absolutne (0 = brak)| Skala | Dominanta ($Mo$) i % | Mediana ($Me$) i rangi | Średnia ($\bar{x}$) i odch. std. | Stosunek („ile razy”) | Typowe przykłady z wykładu |
|---|---|---|---|---|---|
| nominalna | ✅ TAK | ❌ NIE | ❌ NIE | ❌ NIE | kolor oczu, grupa krwi, rodzaj umowy, marka auta, numer bloku, województwo (nawet zakodowane 1–16!) |
| porządkowa | ✅ TAK | ✅ TAK | ❌ NIE | ❌ NIE | wykształcenie, zadowolenie słowne, klasa pralki A–G, wielkość miejscowości, wydatki w przedziałach (<20, 20–50, >50 zł) |
| interwałowa | ✅ TAK | ✅ TAK | ✅ TAK | ❌ NIE | temperatura w °C, IQ Wechslera, rok założenia firmy, godzina rozpoczęcia pracy, ocena na skali 0–10 lub 1–7 |
| ilorazowa | ✅ TAK | ✅ TAK | ✅ TAK | ✅ TAK | dochód w zł, wiek w latach, czas w minutach, metraż mieszkania, liczba pracowników, liczba wizyt |
BPojęcia podstawowe, klasyfikacja cech oraz Konceptualizacja vs Operacjonalizacja
Statystyka opisowa vs Wnioskowanie
- Opis statystyczny (statystyka opisowa): formułujemy wnioski wyłącznie o zbadanych jednostkach (np. badanie pełne całej populacji albo nielosowa próba znajomych).
- Wnioskowanie statystyczne (statystyka indukcyjna/matematyczna): uogólniamy wyniki z próby na całą populację ($\mu, \sigma$) — możliwe tylko wtedy, gdy próba jest właściwie (losowo/reprezentatywnie) dobrana.
Konceptualizacja (CO?) vs Operacjonalizacja (JAK?)
- Konceptualizacja: zdefiniowanie pojęcia (co dokładnie przez nie rozumiemy) oraz wskazanie jego wskaźników (zaobserwowalnych przejawów). Złożone pojęcie wielowymiarowe (np. zaangażowanie w pracę: vigor, dedication, absorption) to konstrukt.
- Operacjonalizacja: zaprojektowanie konkretnego pytania kwestionariuszowego, kafeterii odpowiedzi i sposobu przypisania wartości każdej jednostce.
C5 kryteriów podziału badań statystycznych + 4 etapy badania
| Kryterium | Rodzaje | Po czym poznać na wejściówce (słowa-klucze) |
|---|---|---|
| 1. Cel badania | eksploracyjne · opisowe · wyjaśniające | nowy temat / rozpoznanie → eksploracyjne; „jaki jest rozkład / ile %” → opisowe; „dlaczego / czy X wpływa na Y / teoria i hipoteza” → wyjaśniające |
| 2. Zakres (zasięg) | pełne · częściowe | wszystkie jednostki (np. spis powszechny) → pełne (opis); wylosowana próba → częściowe (wnioskowanie) |
| 3. Źródło danych | pierwotne (field) · wtórne (desk) | zbieramy sami do tego badania → pierwotne; gotowe bazy GUS, Eurostat, raporty → wtórne |
| 4. Technika zbierania | obserwacja · wywiad · ankieta · sondaż | badacz patrzy i notuje → obserwacja; ankieter pyta → wywiad; badany sam wypełnia → ankieta; badanie opinii dużej grupy → sondaż |
| 5. Czas trwania | ciągłe · okresowe · doraźne | stała rejestracja (USC, kasa fiskalna) → ciągłe; powtarzane co kwartał/rok/10 lat → okresowe; jednorazowe → doraźne |
4 etapy badania statystycznego (slajd 53): 1. Projektowanie badania → 2. Zbieranie i zliczanie danych (w tym badanie pilotażowe sprawdzające narzędzie, kontrola i kodowanie) → 3. Prezentacja i analiza danych (tabele częstości, tabele krzyżowe/kontyngencji, wykresy) → 4. Podsumowanie i dyskusja.
DZ tablicy (`3.10_1.jpeg`): Średnia (3 sposoby), Mediana, Dominanta i Tabela częstości
Dane z tablicy: zmienna $X$ = środki wolne do dyspozycji (w tys. zł) u $N = 10$ osób: 1, 1, 2, 2, 3, 3, 6, 6, 6, 10 (suma $\sum x_i = 40$).
- Średnia ($\bar{x} = M = \mu = E(X)$) — 3 wzory dające ten sam wynik $4\text{ tys. zł}$:
- Z surowych danych: $\bar{x} = \frac{\sum x_i}{N} = \frac{40}{10} = 4$
- Z tabeli liczebności ($n_i$): $\bar{x} = \frac{\sum x_i \cdot n_i}{N} = \frac{1\cdot2 + 2\cdot2 + 3\cdot2 + 6\cdot3 + 10\cdot1}{10} = \frac{40}{10} = 4$
- Z częstości względnych ($n_i' = P(X=x_i)$): $\bar{x} = \sum x_i \cdot n_i' = 1\cdot0{,}2 + 2\cdot0{,}2 + 3\cdot0{,}2 + 6\cdot0{,}3 + 10\cdot0{,}1 = 4$ (tu nie dzielisz przez $N$!)
- Mediana ($Me = 3\text{ tys. zł}$): dane rosnąco; dla $N=10$ (parzyste) bierzemy średnią z pozycji $5.$ i $6.$: $(3+3)/2 = 3$. Interpretacja: „Połowa badanych ma nie więcej niż 3 tys. zł wolnych środków, a połowa nie mniej niż 3 tys. zł.”
- Dominanta ($Mo = D = 6\text{ tys. zł}$): wartość o największej liczebności ($n_i = 3$). Częstość dominanty: $P(X = Mo) = 3/10 = 0{,}3$ (30% badanych ma 6 tys. zł).
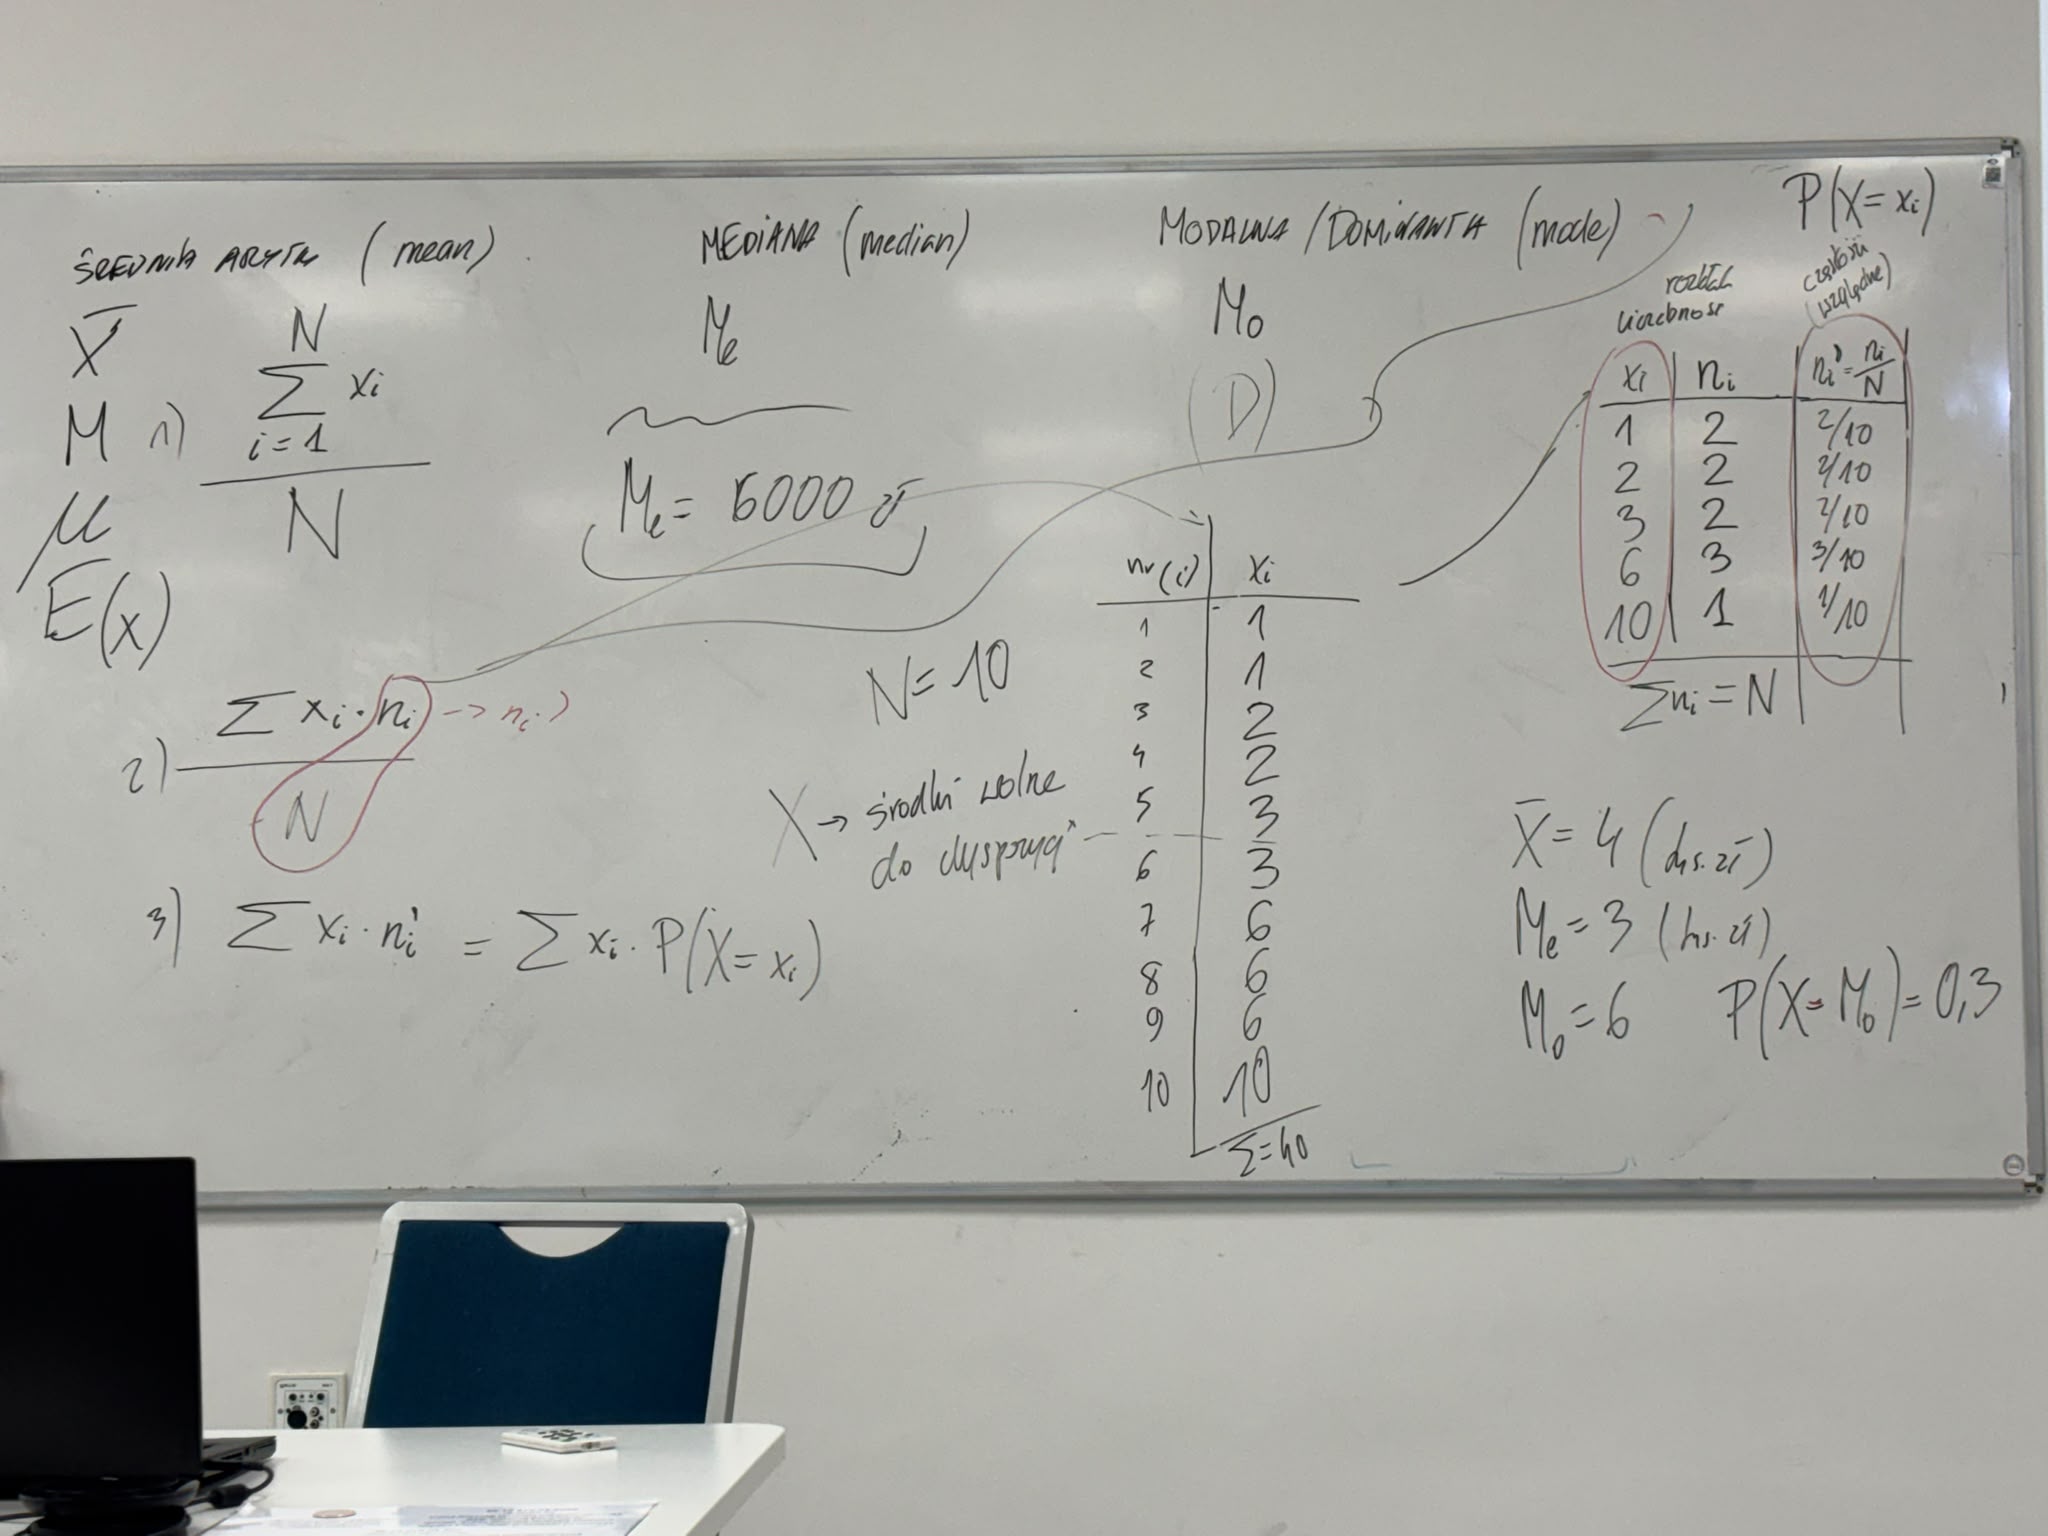
Kliknij zdjęcie tablicy, aby otworzyć w pełnej rozdzielczości.
💻 R i RStudio od zera — pełny rozbiór skryptu z zajęć (3.10.R)
4 okna RStudio i skróty na Macu
- Lewy górny (Source / Skrypt): tu piszesz kod w pliku
.R. Uruchamiasz linijkę skrótemCmd + Enter(Mac) /Ctrl + Enter(Win). - Lewy dolny (Console): tu R wykonuje kod i wypisuje wynik (
[1] ...oznacza początek 1. elementu wyniku). - Prawy górny (Environment): podgląd zapisanych zmiennych (np.
kasa,t). - Prawy dolny (Plots / Help): narysowane wykresy i pomoc.
- Skrót na strzałkę
<-:Option + -(Mac) /Alt + -(Win).
5 żelaznych zasad składni R
- Kropka w ułamkach dziesiętnych (
1.5), przecinek rozdziela kolejne elementy (c(1, 2, 3)). - Tekst i kolory zawsze w cudzysłowie:
"smartfon","blue". - Nawiasy okrągłe
( )= funkcja (mean(kasa)); nawiasy kwadratowe[ ]= wyciągnij pozycję z wektora (kasa[3]). - W R pozycje numerujemy od 1 (a nie od 0).
- Do
prop.table()ibarplot()podajemy tabelętable(kasa), a dohist()surowy wektorkasa!
Cały skrypt z zajęć (3_10.docx) z komentarzem:
# 1. Wektor liczbowy i operacje na całym wektorze ----
czas_bez_tel_sen <- c(10, 10, 15, 90, 20)
mean(czas_bez_tel_sen)          # średnia -> [1] 29
czas_bez_tel_sen / 60           # dzieli każdą z 5 liczb przez 60 -> [1] 0.1666667 0.1666667 0.25 1.5 0.3333333

# 2. Wektor tekstowy i wyciąganie pozycji nawiasem [ ] ----
jakie_urzadzenie_najcz <- c("smartfon", "laptop", "komputer", "tablet", "inne")
jakie_urzadzenie_najcz[3]       # 3. element -> [1] "komputer"
jakie_urzadzenie_najcz[c(1, 3)] # 1. i 3. element -> [1] "smartfon" "komputer"

# 3. Dane z tablicy (kasa) — średnia, mediana, rozkład liczebności i częstości ----
kasa <- c(1, 1, 2, 2, 3, 3, 6, 6, 6, 10)
mean(kasa)                      # średnia -> [1] 4
median(kasa)                    # mediana -> [1] 3

table(kasa)                     # rozkład liczebności (n_i): górny wiersz wartości (1 2 3 6 10), dolny liczebności (2 2 2 3 1)
prop.table(table(kasa))         # rozkład częstości względnych (n_i'): dolny wiersz (0.2 0.2 0.2 0.3 0.1)

t <- table(kasa)                # zapisanie tabeli liczebności do zmiennej t
prop.table(t)                   # rozkład częstości z tabeli t

# 4. Wykresy: słupkowy (z tabeli t) vs histogram (z wektora kasa) ----
barplot(t)                      # wykres słupkowy z tabeli t
hist(kasa)                      # histogram z surowego wektora kasa
hist(kasa, main="wolne środki miesięcznie u 10 osób", xlab="kwota w tys zł", col="blue", border="green")
🃏 Fiszki do szybkiej powtórki (kliknij kartę, aby odwrócić)
Przejrzyj wszystkie 24 karty przed wejściówką — kliknięcie obraca kartę między pojęciem a wyjaśnieniem.
📂 Wszystkie szczegółowe arkusze treningowe i pliki źródłowe
Interaktywne arkusze tematyczne (HTML)
- Temat 1 — Pojęcia, konceptualizacja i skale (pełne notatki + quiz)
- Rodzaje badań statystycznych (5 kryteriów + rozbiór przykładów)
- Z tablicy: średnia (3 sposoby), mediana, dominanta
- R i RStudio od zera + trening pisania kodu
- Trening łączony + egzamin próbny (15 pytań)
- Przewodnik do Projektu cz. I (na piątek 6.11)
Oryginalne materiały od prowadzącej i gotowe pliki Word (.docx)
- 📄 Prezentacja wykładowa: Statystyka opisowa (PDF)
- 📄 Skrypt: Poziomy pomiaru / skale pomiarowe (PDF)
- 📄 Skrypt: Konceptualizacja i operacjonalizacja zmiennych (PDF)
- 🖼️ Zdjęcie tablicy z ćwiczeń 3.10 (JPEG)
- 📝 Oryginalny zapis skryptu R z zajęć (3_10.docx)
- 📘 Projekt cz. I — Wariant A: Praca zdalna a Work-Life Balance (.docx)
- 📘 Projekt cz. I — Wariant B: Narzędzia GenAI w pracy i nauce (.docx)
- 📘 Projekt cz. I — Wariant C: Higiena cyfrowa przed snem (.docx)